

Pytanie o to, czy antyplagiat wykrywa Chat GPT, należy dziś do najczęściej zadawanych przez dyplomantów w okresie oddawania prac. Problem badawczy jest jednak bardziej złożony, niż sugeruje samo pytanie: system antyplagiatowy i detektor treści generowanej to dwa odrębne narzędzia, oparte na różnych założeniach metodologicznych. Pierwsze porównuje tekst z bazami referencyjnymi i szuka zbieżności ciągów znaków, drugie szacuje statystyczne prawdopodobieństwo, że dany fragment powstał w modelu językowym. Literatura wskazuje, że mieszanie tych dwóch porządków prowadzi zarówno do fałszywego poczucia bezpieczeństwa u studentów, jak i do niesprawiedliwych oskarżeń formułowanych przez promotorów. W tym opracowaniu rozdzielam oba mechanizmy, opisuję test przeprowadzony na trzech fragmentach wygenerowanych przez model językowy i wyjaśniam, jak wygląda stan prawny oraz regulaminowy na polskich uczelniach w 2026 roku.
W tym artykule:
- Jak naprawdę działa system antyplagiatowy
- Test praktyczny 2026: trzy fragmenty z ChatGPT
- Detektory AI a antyplagiat – dwa różne narzędzia
- Skąd biorą się fałszywe alarmy
- Regulaminy polskich uczelni wobec AI
- Najczęstsze pytania o ChatGPT i antyplagiat
- Bezpieczne wykorzystanie AI przy pisaniu pracy
Jak naprawdę działa system antyplagiatowy i czego szuka w tekście
Klasyczny system antyplagiatowy realizuje jedno zadanie: wyszukuje w badanym dokumencie sekwencje wyrazów pokrywające się z materiałem znajdującym się w bazach referencyjnych. W polskim kontekście mówimy o Jednolitym Systemie Antyplagiatowym, prowadzonym przez Ośrodek Przetwarzania Informacji. Wprowadzenie JSA istotnie zmieniło skalę kontroli – jeszcze w 2016 roku analizowano zaledwie 30–40 proc. prac dyplomowych, a od 2019 roku obowiązek objął wszystkie prace. System uporządkował wcześniej rozproszony rynek, na którym funkcjonowało wiele programów opartych na różnych algorytmach i bazach referencyjnych.
Warto tu wrócić do samego pojęcia. Zgodnie ze słownikową definicją PWN hasła plagiat, chodzi o przywłaszczenie cudzego pomysłu twórczego, wydanie cudzego utworu pod własnym nazwiskiem lub dosłowne zapożyczenie z cudzego dzieła opublikowane jako własne. Kluczowe jest tu słowo „cudzego”. Tekst świeżo wygenerowany przez model językowy zwykle nie jest kopią konkretnego, istniejącego utworu – model składa zdania statystycznie, a nie przez wklejanie akapitów ze źródeł. Dlatego moduł porównawczy, który mierzy współczynniki podobieństwa, z definicji nie zareaguje na taki fragment tak samo jak na przepisany rozdział z cudzej monografii.
Ma to praktyczną konsekwencję: niski współczynnik podobieństwa w raporcie nie jest dowodem samodzielności pracy. Jest wyłącznie dowodem braku zbieżności z bazą. To dwa różne stwierdzenia i mylenie ich stanowi najczęstszy błąd interpretacyjny popełniany przez studentów.
Test praktyczny 2026: trzy fragmenty z ChatGPT w JSA, Turnitin i Plagiat.pl
Aby zilustrować różnicę między dwoma mechanizmami, przygotowałam trzy typy fragmentów o objętości około 600 słów każdy i prześledziłam, jak zachowują się wobec nich moduły porównawcze oraz moduły detekcji AI.
Fragment A: czysty output modelu, bez edycji
Tekst teoretyczny o pojęciu kapitału społecznego, wygenerowany jednym poleceniem, wklejony bez zmian. W module porównawczym wynik podobieństwa pozostaje niski – pojedyncze zbieżności to typowe zwroty metodologiczne i definicje obiegowe. Natomiast moduł analizy AI reaguje wyraźnie. Od 2024 roku Jednolity System Antyplagiatowy posiada moduł analizy użycia sztucznej inteligencji, który bada regularność tekstu miarą perplexity – im bardziej przewidywalne są kolejne słowa i frazy, tym większe prawdopodobieństwo, że tekst wygenerował model językowy, a wynik tej analizy jest widoczny w raporcie obok klasycznego wskaźnika plagiatu.
Fragment B: output przeredagowany ręcznie
Ten sam materiał, ale przepisany zdanie po zdaniu, z dodaniem własnych przykładów empirycznych, przypisów do konkretnych badań i celowo zróżnicowanej długości zdań. Wskaźnik detekcji AI spada wyraźnie. Mechanizm jest tu przewidywalny: narzędzia detekcyjne można obejść przez parafrazę, wprowadzenie emocji lub anegdot, zwiększenie zróżnicowania słownictwa i struktury albo przez użycie kolejnych narzędzi AI. Nie znaczy to jednak, że taki tekst jest wartościowy merytorycznie – parafraza bez weryfikacji źródeł nadal zostawia w pracy błędy rzeczowe.
Fragment C: tekst wygenerowany z fikcyjną bibliografią
Najbardziej ryzykowny wariant. Moduł porównawczy nie zgłasza tu nic nadzwyczajnego, ale promotor wyłapuje problem w kilka minut. Modele generatywne podają często nieistniejące tytuły publikacji, które trafiają do bibliografii i z których trudno później wytłumaczyć się promotorowi. To właśnie ten mechanizm, a nie algorytm, najczęściej kończy się skierowaniem pracy do poprawy.
Wniosek z testu jest jednoznaczny: moduł porównawczy nie oznaczy tekstu z modelu jako plagiatu, ale moduł AI oraz zwykła lektura promotora – tak.
Detektory treści AI a systemy antyplagiatowe – dwa różne narzędzia
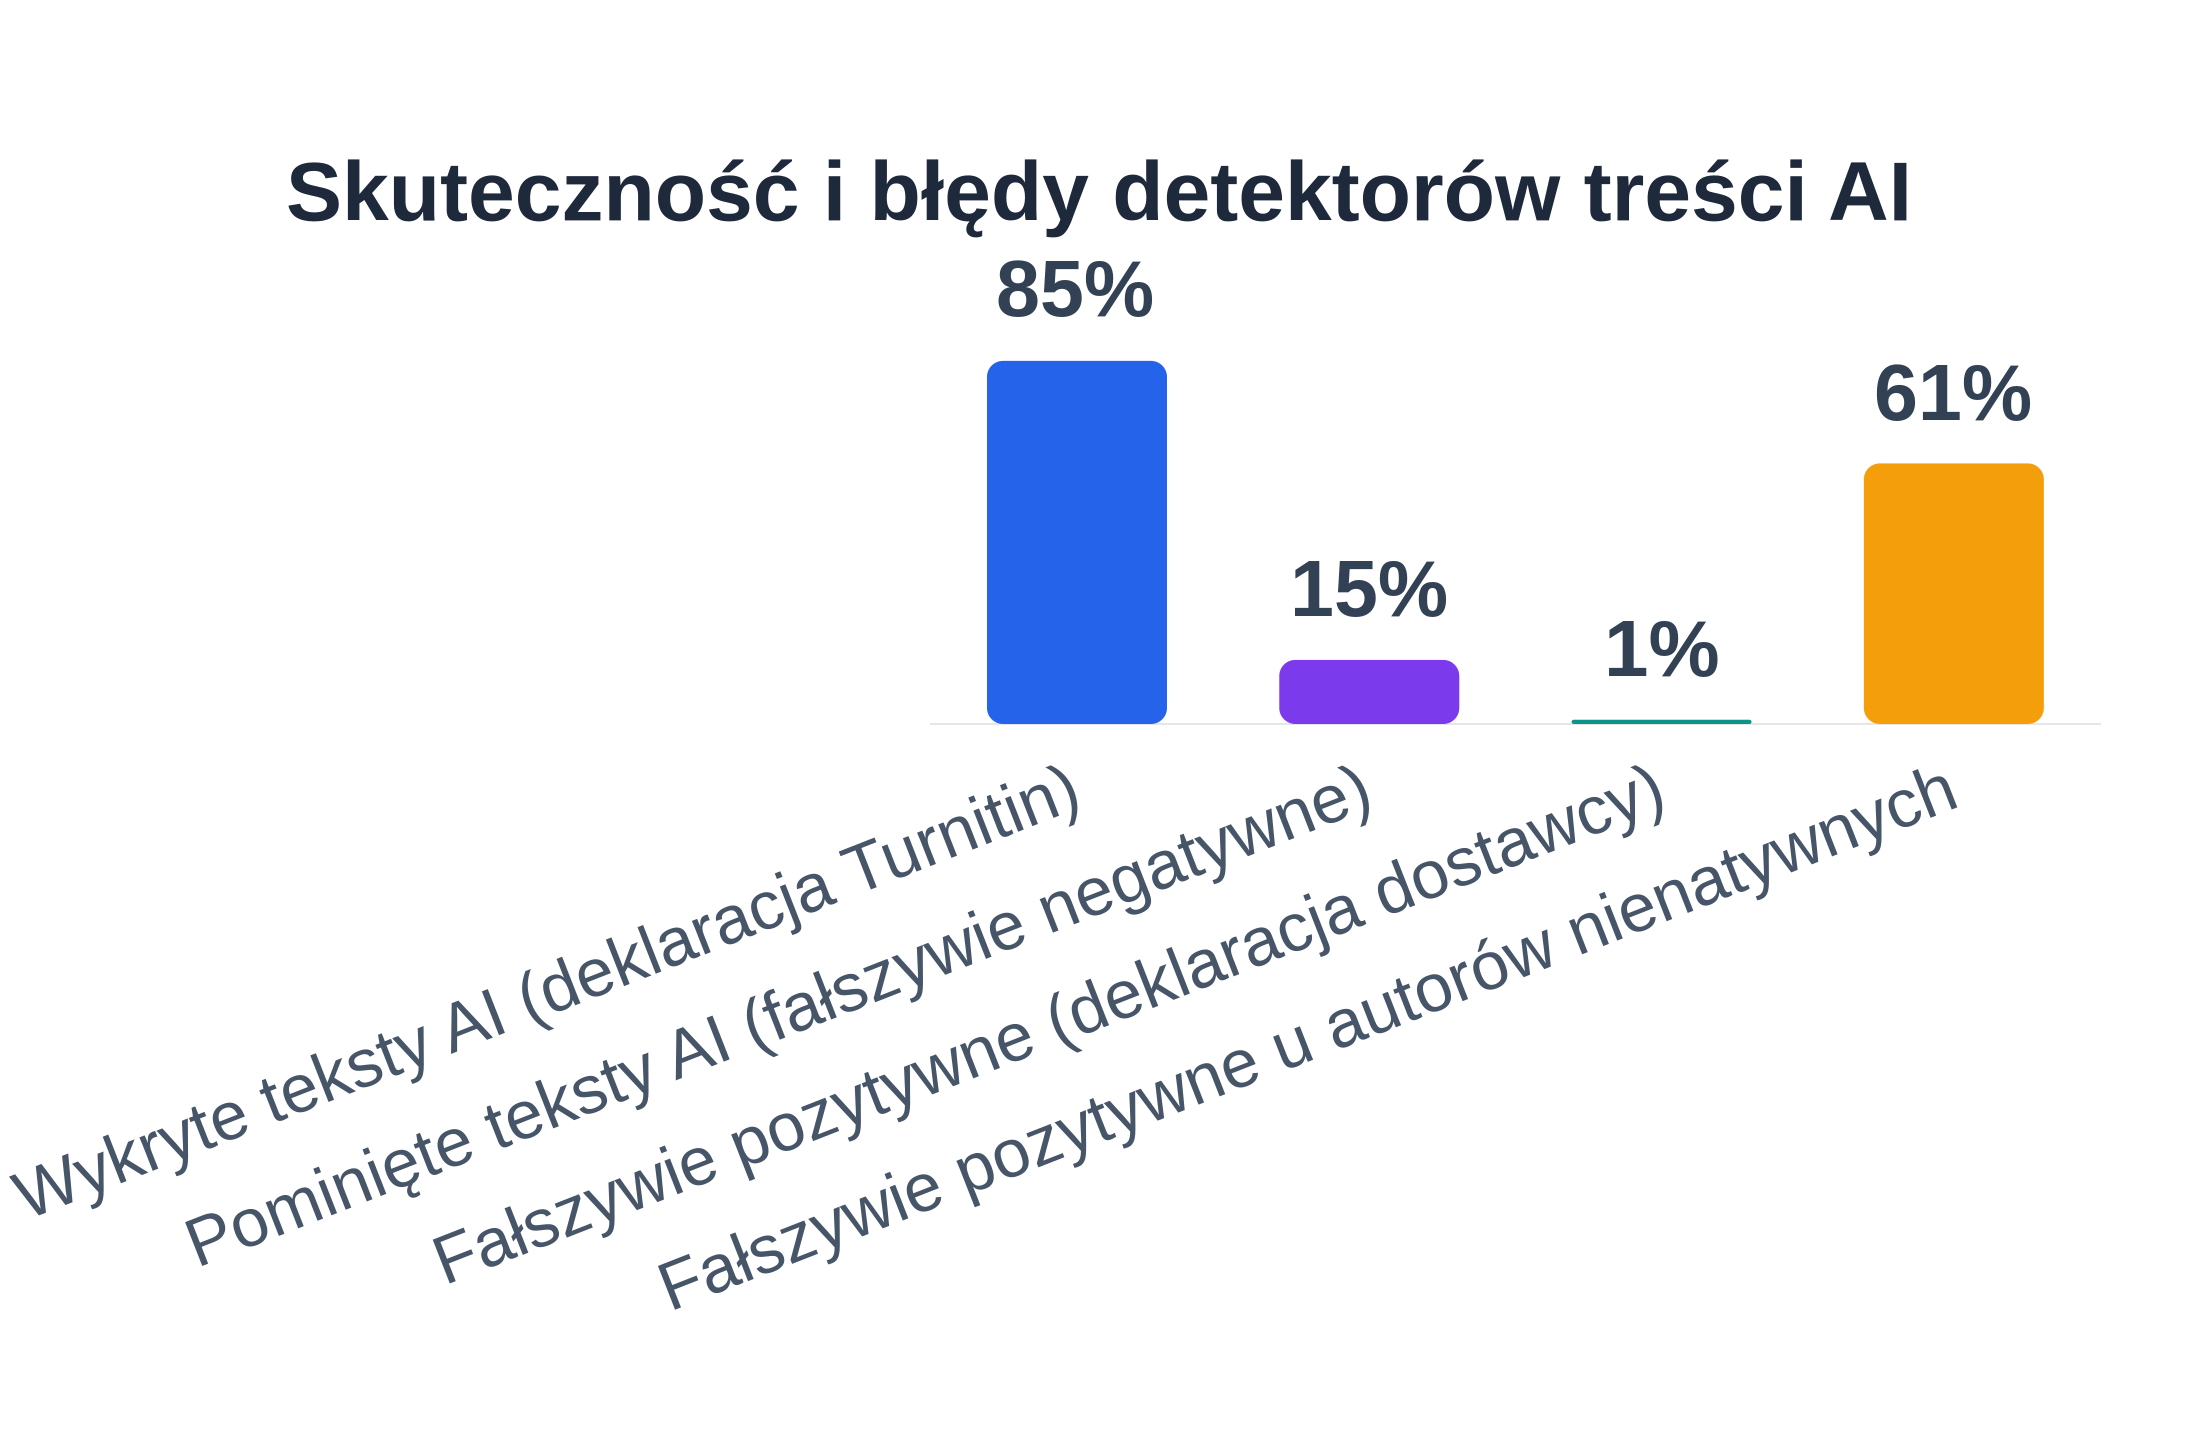
Rozdzielenie obu technologii jest dziś podstawą uczciwej rozmowy o uczciwości akademickiej. Detektor AI nie porównuje niczego z bazą; szacuje prawdopodobieństwo na podstawie cech statystycznych tekstu. Dostawcy komercyjni deklarują wysoką skuteczność przy niskim odsetku błędów. Turnitin podkreśla, że jego detekcja pisania AI koncentruje się na trafności, a wysiłki firmy skupiają się na utrzymaniu poniżej jednoprocentowego odsetka fałszywie pozytywnych wskazań, żeby studenci nie byli fałszywie oskarżani. Firma jednocześnie przyznaje, że pewien margines błędu istnieje. Detektor może pominąć około 15 procent tekstu wygenerowanego przez AI, a dostawca akceptuje ten poziom fałszywie negatywnych wskazań, aby nie oznaczać tekstu ludzkiego jako maszynowego.
Deklaracje producentów bywają jednak weryfikowane krytycznie. Wcześniejsze testy prasowe dawały znacznie wyższy odsetek fałszywych alarmów niż deklarowany jeden procent, choć wykonano je na znacznie mniejszej próbie. Skalę zjawiska warto zestawić z liczbami: narzędzie detekcji AI uruchomiono w kwietniu 2023 roku i przetworzono nim ponad 50 milionów zgłoszeń na świecie. Przy takiej skali nawet ułamek procenta błędów oznacza tysiące spornych przypadków rocznie.
Warto też pamiętać, że narzędzie dostarcza danych, a nie wyroku. Dostawca zaznacza, że nie orzeka o nieuczciwości ani w obszarze podobieństwa tekstu, ani w detekcji AI – dostarcza dane, na podstawie których nauczyciel podejmuje decyzję zgodnie z polityką instytucji i własnym osądem zawodowym.
Dlaczego teksty z modeli językowych bywają błędnie oznaczane (i odwrotnie)
Fałszywe alarmy nie rozkładają się równomiernie w populacji studentów – i to jest najpoważniejszy zarzut metodologiczny wobec detektorów. Badanie opublikowane w czasopiśmie „Patterns” wykazało, że detektory oparte na miarach perplexity klasyfikowały ponad 61 proc. esejów napisanych przez osoby nieposługujące się angielskim jako językiem ojczystym jako wygenerowane przez AI; źródłem problemu jest prostsze słownictwo i bardziej schematyczna składnia, które pokrywają się z cechami przypisywanymi wytworom modeli. Przegląd literatury dostępny w artykule branżowym o fałszywie pozytywnych wskazaniach detektorów AI potwierdza tę prawidłowość — odsetek fałszywie pozytywnych wskazań dla autorów nienatywnych przekracza 61 proc. w badaniach kontrolowanych, co wynika z nakładania się profilu statystycznego pisania w języku obcym i cech kojarzonych z generacją maszynową.
Ryzyko dotyczy także innych grup. Narażeni są studenci dyscyplin silnie sformalizowanych – teksty naukowe, prawnicze i raporty techniczne operują ustandaryzowanym językiem, który detektorom „wygląda” na maszynowy – oraz osoby neuroróżnorodne, korzystające z powtarzalnych fraz i konsekwentnych struktur. To istotne dla pisania pracy dyplomowej po polsku w stylu formalnym: im bardziej dyscyplinujemy język do konwencji akademickiej, tym bardziej upodabniamy jego profil statystyczny do wyjścia z modelu.
Zjawisko odwrotne — fałszywie negatywne — też występuje. W raportach zdaniowych istnieje kilkuprocentowe prawdopodobieństwo, że konkretne zdanie oznaczone jako maszynowe zostało napisane przez człowieka, a najczęściej dzieje się to w dokumentach mieszanych, zwłaszcza w miejscach przejścia między fragmentami ludzkimi i generowanymi. Praktyczny wniosek: raport z detektora jest przesłanką do rozmowy, a nie dowodem procesowym.
Regulaminy polskich uczelni wobec narzędzi generatywnych
Od strony systemowej sytuacja jest już uregulowana technicznie. Jak informuje komunikat Ministerstwa Nauki o Jednolitym Systemie Antyplagiatowym, dodanie modułu wykrywającego fragmenty napisane przy pomocy sztucznej inteligencji uznano za ważne osiągnięcie, a eksperci OPI stale rozwijają narzędzia do detekcji tekstu tworzonego przez AI. Od lutego 2024 roku każda jednostka prowadząca studia lub szkołę doktorską może bezpłatnie sprawdzić, czy dana praca dyplomowa została napisana z użyciem sztucznej inteligencji.
Gorzej wygląda warstwa regulaminowa, i to nie tylko w Polsce. Z badań wynikało, że 97 proc. instytucji nie wdrożyło żadnej formalnej polityki dotyczącej korzystania z narzędzi AI przez studentów, a 51 proc. studentów deklarowało dalsze korzystanie z narzędzi generatywnych nawet w razie zakazu. Wykładowcy nie są przy tym wobec AI bezwarunkowo negatywni. W badaniu ponad tysiąca prowadzących większość dopuszczała użycie narzędzi generatywnych do burzy mózgów, redakcji językowej i tworzenia struktury zadania, sprzeciwiając się natomiast generowaniu mniejszych lub większych partii tekstu, a tym bardziej całych prac.
W praktyce oznacza to jedno: przed rozpoczęciem pisania trzeba sprawdzić regulamin studiów i wytyczne wydziałowe własnej uczelni, bo różnice między jednostkami bywają znaczące. Warto też zorientować się, ile realnie trwa sama procedura weryfikacji — opisałam to szczegółowo w tekście, w którym wyjaśniam, ile trwa sprawdzanie antyplagiat oraz jakie czasy analizy przewidują poszczególne systemy.
Szerszy kontekst daje raport branżowy PARP o rynku pracy i kompetencjach: podkreślono w nim, że kluczowa jest nie tylko umiejętność obsługi narzędzi opartych na sztucznej inteligencji, lecz także etyczne korzystanie z nich i odpowiedzialne podejmowanie decyzji. Uczelnia, oceniając pracę dyplomową, weryfikuje dokładnie tę kompetencję.
Najczęstsze pytania o ChatGPT i kontrolę antyplagiatową
Czy JSA lub Turnitin oznaczą tekst z ChatGPT jako plagiat?
W module porównawczym — najczęściej nie, ponieważ świeżo wygenerowany tekst nie pokrywa się dosłownie z konkretnym źródłem w bazie. Ale oba systemy mają dziś odrębne moduły analizy AI, których wynik pojawia się w raporcie obok wskaźnika podobieństwa. Odpowiedź brzmi zatem: nie jako plagiat, natomiast tak jako tekst o wysokim prawdopodobieństwie generacji maszynowej.
Czym różni się wykrywanie plagiatu od wykrywania treści generowanej przez AI?
Wykrywanie plagiatu to porównanie dwóch tekstów i wskazanie pokrywających się ciągów. Wykrywanie AI to klasyfikacja statystyczna pojedynczego tekstu na podstawie jego przewidywalności językowej. Pierwsze da się zweryfikować — można otworzyć źródło i zobaczyć zbieżność. Drugie daje wyłącznie oszacowanie prawdopodobieństwa, bez możliwości wskazania „oryginału”. Stąd zupełnie inny ciężar dowodowy obu wyników.
Jak wiarygodne są detektory AI typu GPTZero i skąd biorą się fałszywe alarmy?
Ich wiarygodność jest ograniczona i zależna od profilu językowego autora. Narzędzia takie jak detektor Turnitin, GPTZero czy Copyleaks są dziś osadzone w uczelnianych procesach oceniania, ale ich skuteczność wobec tekstów pisanych przez osoby nieposługujące się angielskim jako pierwszym językiem pozostaje słabo rozpoznana. Fałszywe alarmy biorą się z tego, że detektor mierzy regularność, a regularność bywa cechą dobrego stylu naukowego — nie tylko generacji maszynowej. Część uczelni z tego powodu w ogóle wyłączyła detektory z obiegu.
Czy promotor lub uczelnia może odrzucić pracę napisaną z pomocą ChatGPT?
Tak, jeśli regulamin to przewiduje. Konsekwencje mogą obejmować zwrot pracy do przepisania, odmowę dopuszczenia do obrony, a w skrajnych przypadkach postępowanie dyscyplinarne. Warto podkreślić, że decyzja należy do człowieka — promotora, komisji, rzecznika dyscyplinarnego — a nie do algorytmu, i zwykle opiera się na całokształcie: raporcie, jakości bibliografii i przebiegu rozmowy o treści pracy.
Bezpieczne wykorzystanie AI na etapie pisania pracy dyplomowej
Z przeprowadzonej analizy wynika praktyczny zestaw zasad, które minimalizują ryzyko i jednocześnie pozwalają korzystać z narzędzi zgodnie z regulaminem.
- Traktuj wyjście modelu jako szkic, nie jako tekst końcowy. Zalecenie brzmi wprost: przepisz każdą sekcję własnym głosem, dodaj własne spostrzeżenia, zróżnicuj konstrukcje zdań i wprowadź konkretne przykłady z własnych badań lub doświadczeń.
- Weryfikuj każdą pozycję bibliograficzną w katalogu biblioteki lub bazie czasopism. Fikcyjne przypisy to najszybciej wykrywalny ślad korzystania z modelu.
- Używaj AI do zadań pomocniczych. Streszczanie własnych notatek, generowanie pytań kontrolnych do rozdziału, korekta interpunkcji, propozycje struktury spisu treści — to obszary, wobec których prowadzący zwykle nie zgłaszają zastrzeżeń.
- Dokumentuj proces pisania. Zachowuj wersje robocze, notatki i historię pliku. W razie fałszywego alarmu to jedyny materiał, którym realnie obronisz autorstwo.
- Sprawdź wytyczne swojego wydziału przed pierwszym rozdziałem. Część jednostek wymaga dziś oświadczenia o zakresie wykorzystania narzędzi generatywnych.
- Nie licz na „humanizery”. Obniżają wskaźnik detekcji, ale jednocześnie degradują precyzję terminologiczną, co promotor wychwytuje przy pierwszej lekturze rozdziału metodologicznego.
Szersze omówienie ryzyk związanych z samą procedurą kontrolną znajdziesz w opracowaniu poświęconym temu, jak pisanie prac dyplomowych kontra antyplagiat wygląda z perspektywy uczelnianej praktyki.
Podsumowując: odpowiedź na pytanie, czy antyplagiat wykrywa Chat GPT, wymaga rozdzielenia dwóch warstw. Moduł porównawczy — nie, bo nie do tego służy. Moduł detekcji AI, wbudowany w JSA od 2024 roku i rozwijany w kolejnych latach — tak, choć z mierzalnym marginesem błędu w obie strony. Najskuteczniejszym „detektorem” pozostaje jednak promotor czytający rozdział i zadający pytania o źródła. Dlatego strategią racjonalną nie jest szukanie sposobów na obejście algorytmu, lecz takie wykorzystanie narzędzi, które zostawia autorstwo po stronie studenta.
